Sdcb.Arithmetic
AI 时代的 .NET 数值计算:用纯托管 C# 实现 GMP / MPFR 级别的任意精度算术。没有原生 DLL,AVX-512 / AVX2 / NEON / WASM SIMD 全都用上。
dotnet add package Sdcb.Arithmetic
三个类型
GMP 与 MPFR 的能力,.NET 的手感
三个类型都实现了 .NET 泛型数学接口(INumber<T>、IBinaryInteger<T>、IBinaryFloatingPointIeee754<T>),并能与 System.Numerics.BigInteger 互转。每一个 BigInt 运算都与 BigInteger 和原生 GMP 交叉验证,每一个 Real 函数都在全部舍入模式下与 MPFR 逐位比对。
using Sdcb.Arithmetic;

// BigInt ≈ GMP mpz_t
BigInt p = BigInt.Pow(2, 521) - 1;               // Mersenne prime M521
bool prime = p.IsProbablePrime();                // BPSW + Miller–Rabin
BigInt m = BigInt.ModPow(3, p - 1, p);           // 1, Fermat says hi

// BigRational ≈ GMP mpq_t, always canonical
BigRational q = new BigRational(1, 3) + new BigRational(1, 6);   // 1/2

// Real ≈ MPFR mpfr_t: correctly rounded, five rounding modes
Real.DefaultPrecision = 256;                     // bits
Real pi = Real.Pi();
Real e = Real.Exp(pi * Real.Sqrt(163));          // 262537412640768743.99999999999925…
Real lo = Real.Sqrt(2, 64, RealRounding.TowardNegative);
Real hi = Real.Sqrt(2, 64, RealRounding.TowardPositive); // √2 ∈ [lo, hi], guaranteed实验室
下面每个数字,都是 Sdcb.Arithmetic 在你的浏览器里现场算的
同一份 NuGet 包被编译成 .NET WebAssembly(AOT + SIMD128),跑在一个 Web Worker 里。等待加载
① double 是怎么骗你的
- double
- …
- Real · 200 bit
- …
因为 double 里的 0.1 其实是:
…
- double
- …
- Real · 256 bit
- …
它差一点点就是整数——double 根本看不到这“一点点”,连整数部分的末几位都错了。
- double
- …
double 给出一个 10²¹ 量级的数,而且不会有任何警告;真值是 −0.8273960599…,要 122 位以上精度才算得出来。
- √2 ≥
- …
- √2 ≤
- …
只用 64 位精度,但 TowardNegative / TowardPositive 舍入给出的区间在数学上一定包含真值——区间算术的基础。
每一次舍入误差都会把序列推向错误的不动点 100。精度越高,坚持得越久——任意精度不是“多几位小数”,而是能不能算对。
② 混沌的真相
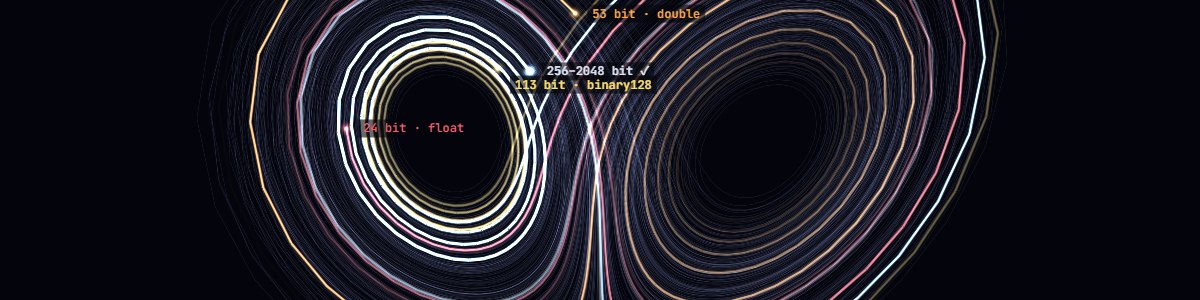
洛伦兹系统,同一个初值 (1, 1, 1)、同一个 RK4、同一个步长 0.005——唯一的区别是每一步怎么舍入。float、double 各自漂走之后,哪条才是真的?Real 用 256 位和 1024 位各算一遍,两条轨迹全程重合:它们就是真相。
- float 偏离
- …
- double 偏离
- …
- |double − Real|
- …
- Real 256 vs 1024
- …
- Real 耗时 256 / 1024
- …
与 Real 的距离(对数坐标):误差每隔几个时间单位放大 10 倍,直到吞掉整条轨迹。
全屏 · 24 → 2048 bit
精度阶梯 · 蝴蝶效应 · 三体
七种精度从同一个点出发,一条接一条地叛逃——每多 1 位,就多约 0.76 个时间单位的未来。还有 5 种吸引子、可调参数与毕达哥拉斯三体。
③ π 竞速,与大数赛跑
- Real.Pi · 正确舍入
- –
- 转十进制
- –
- Chudnovsky · BigInt
- –
- 两种实现一致
- –
左图:把每一位数字 d 当成方向 36°·d 走一步——10 万步的随机游走。
性能
比 BigInteger 快得多,离原生 GMP 不远
AMD Ryzen 7 5800X(AVX2),.NET 10,操作数 1–65536 个 64 位 limb。完整数据与方法
| 运算 | 相对 BigInteger 的加速 | 耗时 / 原生 GMP 6.3(越低越好) |
|---|---|---|
| 乘法 | 1.9–28× | 1.3–1.6× |
| 除法 2N/N | 2.2–5.9× | 1.5–2.6× |
| 模幂 | 4.2–7× | 1.3–2.8× |
| GCD | 1.5–5.8× | 0.9–1.4× |
| 加 / 减 / 移位 | 2.5–11× | 1.1–3.1× |
| 十进制 ToString / Parse | 最高 16× / 4× | 0.5–1.9× |
Real 对比原生 MPFR 4.2(53–16384 位,双方都正确舍入):加/乘 1.3–2.5×,除/开方 1.3–3.3×,exp/sin/atan 0.9–1.8×,log/pow 1.6–2.7×。
文档
寻找旧的 GMP/MPFR P/Invoke 绑定?它们搬到了 sdcb/Sdcb.Arithmetic.