流式输出里冒出 �
2Bit 模型更爱把一个多字节字符拆成几个 byte token。第一个 token 单独解码只有半个 UTF-8 序列,于是流里先冒出 �,最后结果却是对的。
token修复前修复后E3 81…ご�…ご (扣住)96…ござ…ござ
Generate
string next = model.Tokenizer
.DecodeVisible(generated)
.TrimEnd('\uFFFD');纯 C# 的混元翻译,现在能跑在显卡上了。不依赖 llama.cpp,引用一个 NuGet 包,连模型权重都带上。
dotnet add package Sdcb.HyMT2Sharp
dotnet add package Sdcb.GgufWeights.Hy-MT2-1.8B-2Bit
第二行是 2Bit 模型权重(约 573 MB),也可以直接传 GGUF 文件路径。
翻译竞速
每条赛道先按 prefill 速度吃掉 83 个 prompt token,再按 decode 速度吐出 60 个 token。速度取自 Ryzen 7 5800X + RTX 3080 Ti 上的 prefill 512 / decode 128 实测,不是在你的浏览器里跑模型。
SimdPaddleOCR is officially released today (NuGet: Sdcb.SimdPaddleOCR). It is a complete OCR inference engine written entirely in C#. It does not depend on Paddle Inference or ONNX Runtime, and it does not require shipping OpenCV native libraries.
prefilldecodeQ4_K_M 起可以和 llama.cpp 正面对比——GPU decode 我们还慢一截。
腾讯自有量化格式,llama.cpp 的 CPU 和 GPU 都加载不了,HyMT2Sharp 的 Vulkan 后端是目前唯一的 GPU 路径。
dotnet add package Sdcb.HyMT2Sharp
dotnet add package Sdcb.GgufWeights.Hy-MT2-1.8B-1.25Bitusing Sdcb.GgufWeights.Hy_MT2_1_8B_1_25Bit;
using Sdcb.HyMT2Sharp.Backends;
using Sdcb.HyMT2Sharp.Model;
// Metal → Vulkan → CPU
using HunyuanDenseModel model = new(Weights.Model(), backend: BackendFactory.Create());腾讯自有量化格式,llama.cpp 的 CPU 和 GPU 都加载不了,HyMT2Sharp 的 Vulkan 后端是目前唯一的 GPU 路径。 推荐:体积只比 Q4_K_M 的一半多一点,decode 最快。
dotnet add package Sdcb.HyMT2Sharp
dotnet add package Sdcb.GgufWeights.Hy-MT2-1.8B-2Bitusing Sdcb.GgufWeights.Hy_MT2_1_8B_2Bit;
using Sdcb.HyMT2Sharp.Backends;
using Sdcb.HyMT2Sharp.Model;
// Metal → Vulkan → CPU
using HunyuanDenseModel model = new(Weights.Model(), backend: BackendFactory.Create());对比 llama.cpp:CUDA prefill 1.10×、decode 0.82×;CPU prefill 1.72×。
dotnet add package Sdcb.HyMT2Sharp
dotnet add package Sdcb.GgufWeights.Hy-MT2-1.8B-Q4_K_Musing Sdcb.GgufWeights.Hy_MT2_1_8B_Q4_K_M;
using Sdcb.HyMT2Sharp.Backends;
using Sdcb.HyMT2Sharp.Model;
// Metal → Vulkan → CPU
using HunyuanDenseModel model = new(Weights.Model(), backend: BackendFactory.Create());对比 llama.cpp:CUDA prefill 1.18×、decode 0.94×;CPU prefill 2.90×。
dotnet add package Sdcb.HyMT2Sharp
dotnet add package Sdcb.GgufWeights.Hy-MT2-1.8B-Q6_Kusing Sdcb.GgufWeights.Hy_MT2_1_8B_Q6_K;
using Sdcb.HyMT2Sharp.Backends;
using Sdcb.HyMT2Sharp.Model;
// Metal → Vulkan → CPU
using HunyuanDenseModel model = new(Weights.Model(), backend: BackendFactory.Create());对比 llama.cpp:CUDA prefill 1.04×、decode 0.90×;CPU prefill 2.45×。
dotnet add package Sdcb.HyMT2Sharp
dotnet add package Sdcb.GgufWeights.Hy-MT2-1.8B-Q8_0using Sdcb.GgufWeights.Hy_MT2_1_8B_Q8_0;
using Sdcb.HyMT2Sharp.Backends;
using Sdcb.HyMT2Sharp.Model;
// Metal → Vulkan → CPU
using HunyuanDenseModel model = new(Weights.Model(), backend: BackendFactory.Create());后端
BackendFactory.Create() 按 Metal → Vulkan → CPU 自动选择;也可以传 "cpu" / "vulkan" / "metal",或设环境变量 HYMT_BACKEND。CPU 内核再按指令集逐级降级。
Vulkan / Metal 的互操作、调度、内存管理全部用 C# 写,仓库语言统计仍是 100% C#。
Intel Arc B580:2Bit 11,039 / 243 tok/s;Q4_K_M 10,620 / 208,同卡 llama.cpp Vulkan 7,345 / 194。AMD RDNA 有默认 tile 调优。
一个值得单独说的修复
GGUF 量化块里的 d / dmin 缩放因子是 fp16,而真实权重里这些值几乎全是 fp16 的次正规数。旧的 fp16 → fp32 写法中间会产生 fp32 次正规数,每次转换都触发约 150 个周期的微码辅助。
随机字节造的合成权重几乎不会落进次正规区间,所以微基准一直看不出来。改成在整数尾数上计算后结果逐位一致。
tok/s · 越长越好
示例
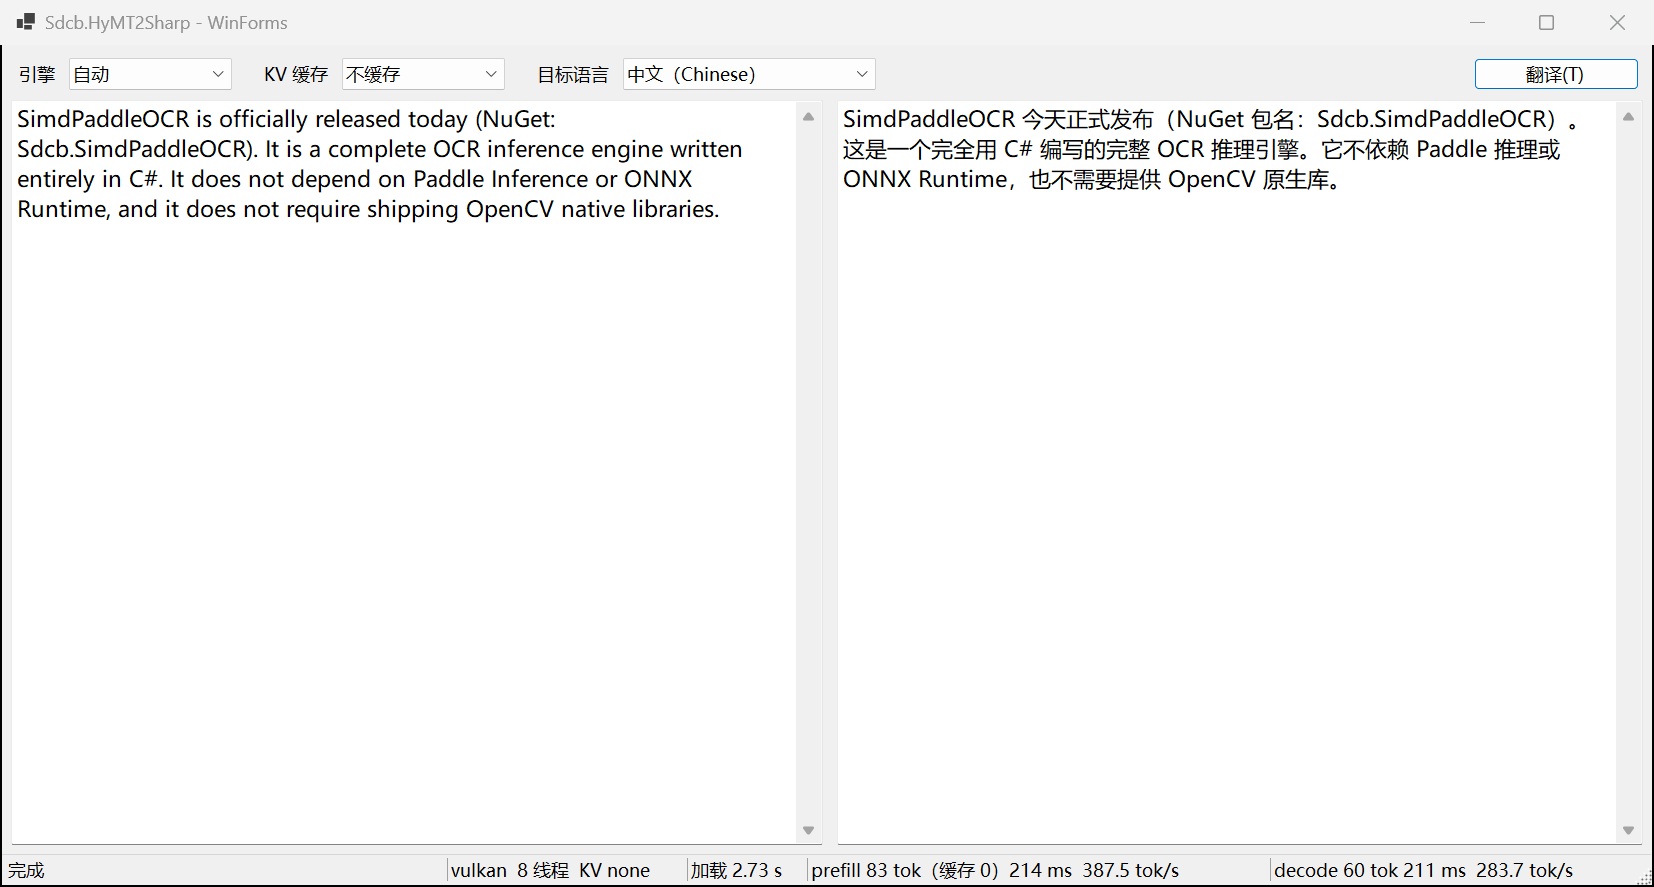
引擎选"自动",在 3080 Ti 上用 Vulkan:decode 60 个 token 用了 211 ms,约 284 tok/s。
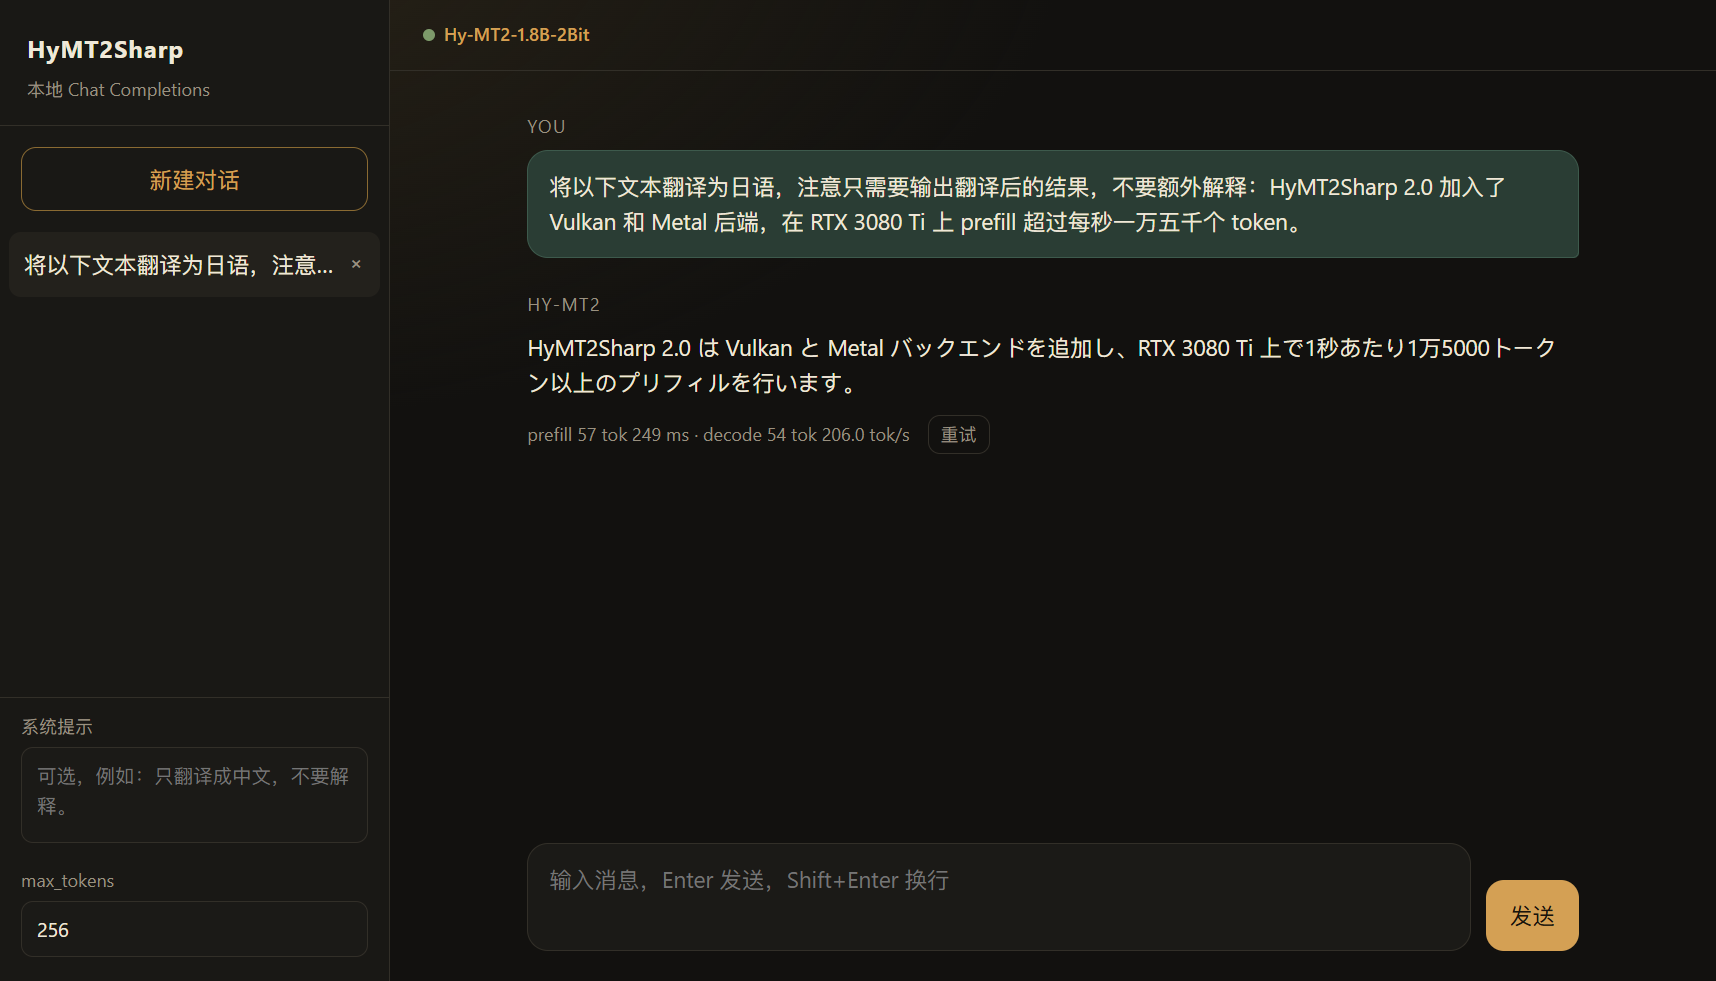
OpenAI 兼容的 /v1/chat/completions,带 SSE 流式和一个聊天页。
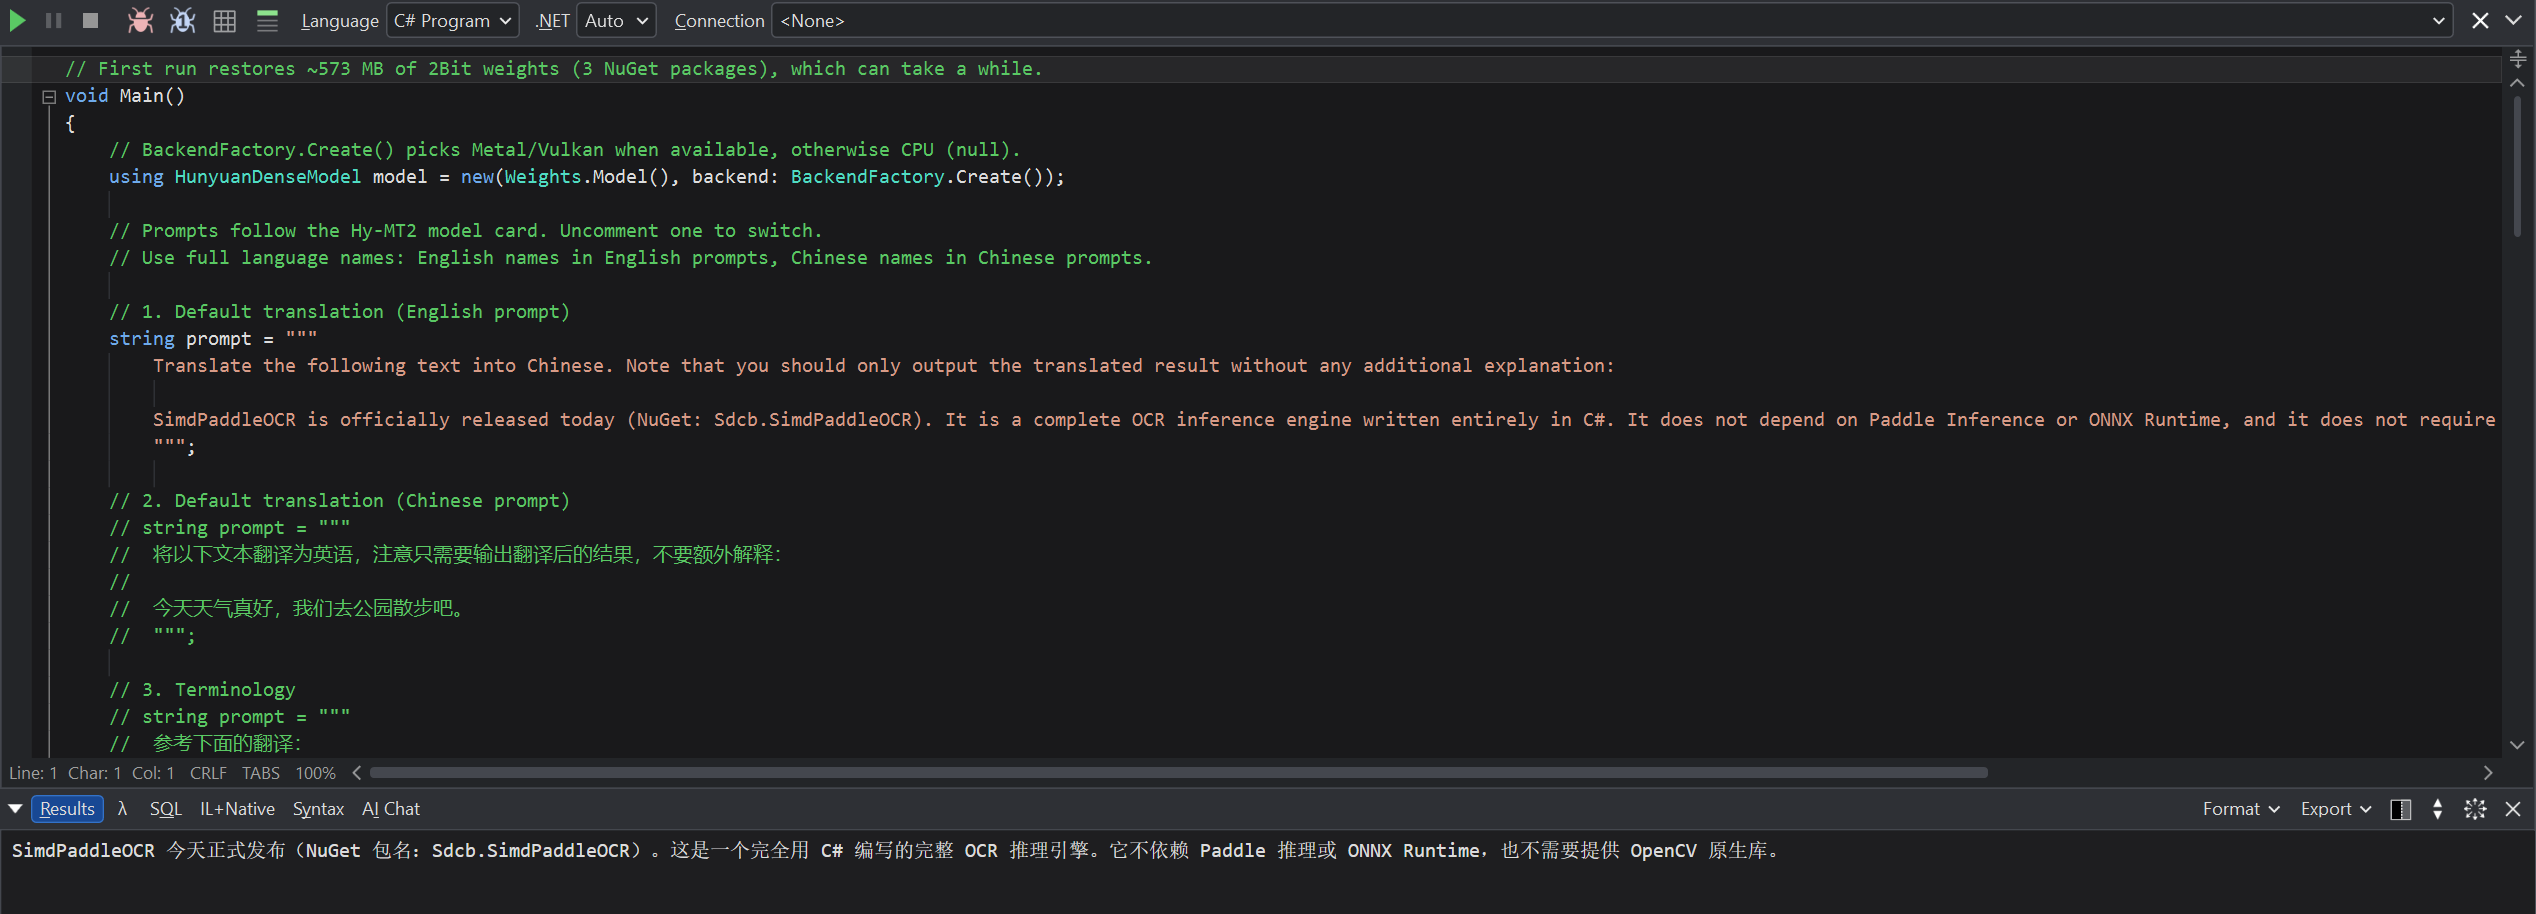
包里自带 hello-world、cli、minimal-api 三个脚本,引用后在 Samples 面板里就能看到。
两个坑
2Bit 模型更爱把一个多字节字符拆成几个 byte token。第一个 token 单独解码只有半个 UTF-8 序列,于是流里先冒出 �,最后结果却是对的。
string next = model.Tokenizer
    .DecodeVisible(generated)
.TrimEnd('\uFFFD');原来的 Dispose 只调 vkDestroyDevice,以为会顺带回收设备名下的资源。NVIDIA 驱动并不会,每次重新加载漏约 4.3 GB。现在 buffer、pipeline、shader module、fence、descriptor pool、command pool 全部单独跟踪、逐个释放。
从 1.0 升级
命名空间还是 Sdcb.HyMT2Sharp.Model,new HunyuanDenseModel(path) 和 Forward 的用法没变;不传 backend 时行为与 1.0 一样。
# 1.x
dotnet remove package Sdcb.HyMT2Sharp.Gguf
dotnet remove package Sdcb.HyMT2Sharp.Kernels
dotnet remove package Sdcb.HyMT2Sharp.Model
# 2.0
dotnet add package Sdcb.HyMT2Sharp已知限制